1. 概述
伴随着 CNN 模型的发展,YOLO 系列也来到了第三个版本 YOLO v3[1],2018 年,作者 Redmon 又在YOLOv2[2] 的基础上做了一些改进,总结起来包括了三个方面:
- 特征提取网络,在 YOLO v3 中采用了 Darknet-53 网络结构代替原来的 Darknet-19
- 增加了特征金字塔网络结构,实现了多尺度的检测
- 分类方法使用逻辑回归代替了原来的 Softmax
通过以上的更新,YOLO v3 也成为具备实用性的版本。
2. YOLO v3 的算法原理
2.1. YOLO v3 与 YOLO v2 在结构上的对比
为了更好的理解 YOLO v3 相较于 YOLO v2 的优化,首先,我们先分别看下完整的 YOLO v2 和 YOLO v3 的网络结构,首先,YOLO v2 的网络结构如下图所示:
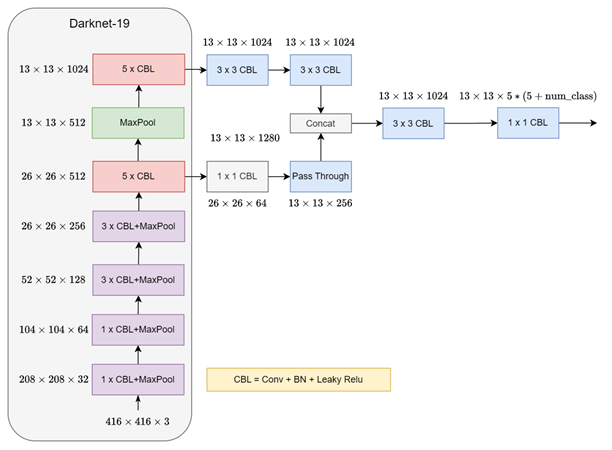
YOLO v2 的整个网络结构中以卷积和池化为主,YOLO v3 的网络结构如下:
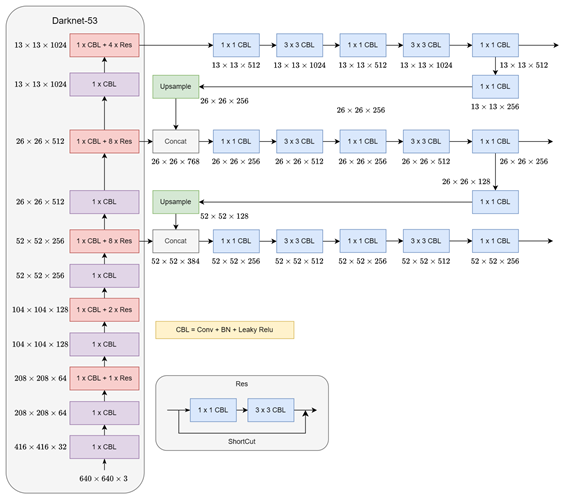
在 YOLO v3 中已经引入了很多当下较为流行的 CNN 设计思路,包括残差模块,这有利于增强深层特征提取能力。YOLO v2 使用 Darknet-19 作为主干网络,具有较好的速度,但网络深度和特征表达能力仍有限。YOLO v3 使用 Darknet-53,其中的 53 指主干网络中具有可学习权重的卷积层数量为 53 层。残差连接使梯度能够沿着捷径传播,缓解深层网络训练中的梯度消失和优化困难问题。
2.2. 残差连接
残差连接最早是在 ResNet[3] 网络结构中被提出,后被广泛使用,现在俨然已经成为 CNN 的标配。在 YOLO v3 中大量使用了残差连接的结构,如下图所示:
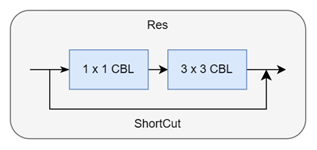
有了残差结构,网络可以被训练的很深,这样能够使得网络能够提取到更多的图像语义信息,从而有更强的特征表达能力。这部分就不再详细概述了,也算是深层 CNN 网络中的标准配置了。
2.3. 多尺度
YOLO v2 虽然使用了多种尺寸的 Anchor,也通过 Passthrough Layer 融合过浅层特征,但最终仍然主要在一个 的特征图上进行预测,在上面 YOLO v2 的结构图中也能看到,最终图像被划分为 个网格,每个网格负责预测若干目标框。具体的过程如下所示:
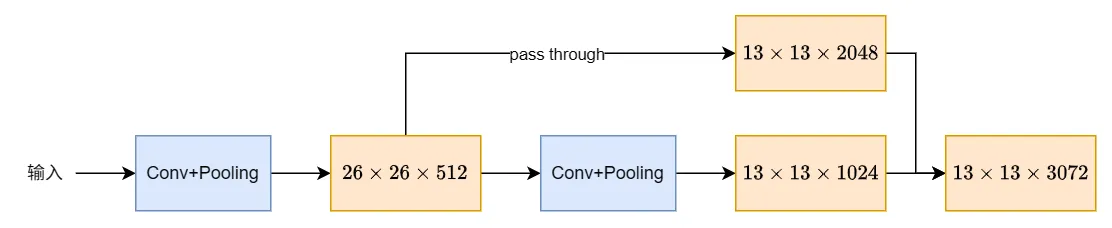
这种设计最明显的缺陷就是在一个网络中无法同时处理大目标和小目标。在 YOLO v3 之前,已经有模型在使用特征金字塔 FPN[4](Feature Pyramid Network)的结构,FPN 的结构如下图所示:
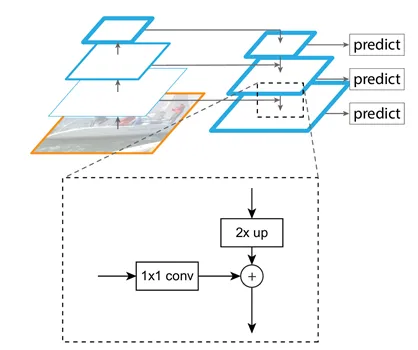
YOLO v3 也是借鉴了 FPN 的思想,融合不同分辨率的特征,并在三个尺度上分别进行检测,在上面 YOLO v3 的结构图上可以看出来。最终会在三个尺度上分别工作:
- 图中最上方 的特征图,主要负责大目标
- 图中中间的 的特征图,主要负责中等目标
- 图中最下方 的特征图,主要负责小目标
这里需要注意一个细节,每个尺度上设置了 3 个 Anchor,这样总共使用 9 个 Anchor。
2.4. 分类从 Softmax 改为独立的 Sigmoid
在 YOLO v2 中的分类部分采用 Softmax,对于每一个目标框,其输出的每一个类别的概率之和为 1,即:
其中, 为所有的类别,但在实际场景中每个目标框中可能会包含多个类别。
在 YOLO v3 也是把这部分改变了,对于每个类都是独立的 Logistic Classifier,也就是采用 Sigmoid,具体为:
此时,分类损失也相应改为 Binary Cross Entropy(BCE):
这就使得 YOLO v3 更适合类别可以重叠的多标签场景。
2.5. Objectness 预测采用 Logistic 回归
这是 YOLO v3 中的另一处优化,YOLO v3 中继续预测每个 Anchor 是否包含目标,但采用 Logistic 回归来预测 Objectness 分数,并使用 BCE 训练相关置信度预测。原来在 YOLO v1[5] 中这部分也是采用的 MSE 作为损失函数,其数学表示为:
- 包含物体的置信度误差(正样本)
- 不包含物体的置信度误差(负样本)
其中, 表示的是 Confidence。
在 YOLOv1 把置信度全当成了回归问题。在 YOLO v3 中不再使用简单的 MSE,而是采用了 BCE,并配合 Sigmoid 函数,将置信度预测变成了一个二分类问题。
该损失由两部分组成:
- 正样本损失:对于负责预测物体的 Anchor 框,其置信度应接近 1。
- 负样本损失:对于不负责预测物体的背景框,其置信度应接近 0。同时,会通过权重系数 来降低大量简单负样本对总损失的贡献。
3. 总结
YOLO v3 整体上与 YOLO v2 结构上保持一致,保留了锚框的机制,但在各细节上,也是吸收了其他模型的发展,把一些优秀的设计引入到 YOLO v3 中,总结起来来看,主要有这样几点:1. 更深的网络,从 YOLO v2 中使用的 Darknet-19 提升到了 Darknet-53,通过更深的网络和残差连接获取更强的特征表达能力;2. 借鉴了特征金字塔 FPN,解决多尺度目标检测的问题;3. 使用独立的 Sigmoid 和 BCE,不再使用 Softmax,这也解决了多标签预测的问题。
参考文献
[1] Redmon J, Farhadi A. Yolov3: An incremental improvement[J]. arXiv preprint arXiv:1804.02767, 2018.
[2] Redmon J, Farhadi A. YOLO9000: better, faster, stronger[C]//2017 IEEE conference on computer vision and pattern recognition (CVPR). Ieee, 2017: 6517-6525.
[3] He K, Zhang X, Ren S, et al. Deep residual learning for image recognition[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 770-778.
[4] Lin T Y, Goyal P, Girshick R, et al. Focal loss for dense object detection[C]//Proceedings of the IEEE international conference on computer vision. 2017: 2980-2988.
[5] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.