1. 概述
Florence-2[1] 是微软研究团队提出的又一统一视觉基础模型(Unified Vision Foundation Model),为什么说是“又一”,因为在此之前,还有 Florence[2],Florence 和 Florence-2 都在致力于解决统一视觉问题。回顾下,在以往处理视觉问题时,如图像分类、目标检测、目标定位、图像描述、OCR 等任务,我们基本的逻辑都是针对不同的问题设计不同的模型和输出头,例如分类就是分类头,目标检测就是分类头+回归头等等,那么是否存在统一的架构来解决诸多的这些视觉问题呢?
Florence 算法的核心还是基于 CLIP 这样的对比学习框架来学习大规模的视觉表示以及视觉和文本的对齐,以及在此基础上将这些视觉表示扩展到目标级、细粒度视觉语言、视频和深度等任务;而 Florence-2 已经抛开了这一切的枷锁,Florence-2 的核心是用统一的、基于任务提示词的序列生成框架完成多种视觉任务,不再为图像分类、目标检测、目标定位、图像描述、OCR 等任务分别设计不同的模型和输出头,而是把这些视觉任务统一转换成一种基于文本序列的生成任务。
2. Florence-2 算法原理
2.1. Florence-2 框架
为了弄清楚 Florence-2 算法是如何用统一的框架来解决众多的视觉问题的?我们先来看下 Florence-2 的算法框架,如下图所示:
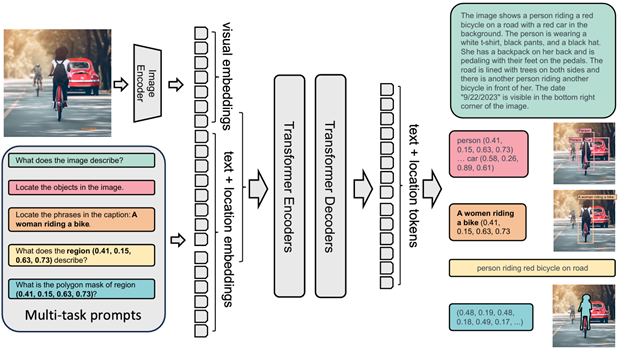
从上面的 Florence-2 的框架图可以看到 Florence-2 算法中主要由三个模块组成:
- 视觉编码器 Image Encoder,其目的是把图像变成视觉特征序列;
- 多模态融合 Multimodal Merge,输入除了视觉特征外,还有任务的提示词,多模态融合编码器的主要职责是把视觉特征与任务提示词融合,建立图像和文本之间的联系;
- 多模态编解码 Multimodal Encoder Decoder,根据融合后的图片+文本特征,针对不同问题,如描述、类别、坐标或多边形等逐 Token 生成最终的输出。
下面将对这三个主要模块详细分析。
2.2. 视觉编码器 Image Encoder
在 Florence-2 算法中,视觉编码器 Image Encoder 部分使用的是 DaViT[3] 算法。DaViT 算法是 ViT[4] 和 Swin Transformer[5] 算法的改进版。DaViT 采用了 Swin Transformer 中局部注意力,也就是 W-MSA 部分,摒弃了复杂的 SW-MSA 模块,而是在空间维度采用窗口注意力,以建模局部空间位置之间的关系,在通道维度采用分组注意力,以在通道维度上融合全图上下文,其分层结构还能在不同阶段逐渐扩大感受野、提取更抽象的语义信息。具体如下图所示:
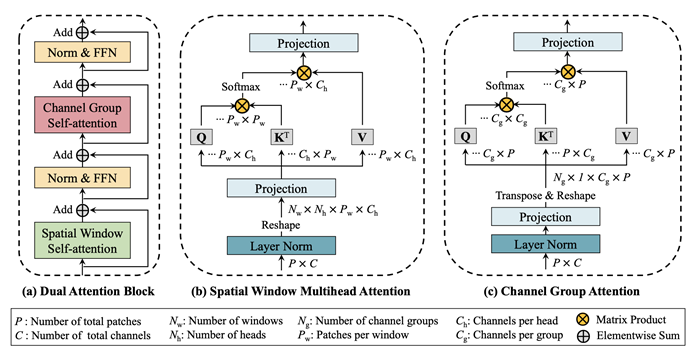
在 DaViT 算法中,对于输入的图片 ,经过视觉编码器后,模型得到一张高层特征图:
然后把空间维度展平 ,得到:,其中,。
每一行就是一个视觉 Token,表示图像某个空间位置经过多层特征提取后的信息。
DaViT 输出的特征维度不一定等于文本 Transformer 的隐藏维度。假设语言模型的隐藏维度为 ,此时就需要一个可学习的线性投影:
其中,。因此,。这样,视觉 Token 和文本 Token 就拥有相同的向量维度,可以进入同一个 Transformer Encoder。
2.3. 多模态融合 Multimodal Merge
2.3.1. 任务与任务提示词
对于 Florence-2 算法来说,输入除了图片之外,还有任务的提示词,参考 Florence-2 的实现[6],主要有如下几种:
<CAPTION>:生成简短图像描述<DETAILED_CAPTION>:生成详细图像描述<MORE_DETAILED_CAPTION>:生成更详细的图像描述<OCR>:识别图像中的文字<OCR_WITH_REGION>:识别图像中的文字并定位每段文字<OD>:目标检测<DENSE_REGION_CAPTION>:密集区域描述<REGION_PROPOSAL>:找出候选区域<CAPTION_TO_PHRASE_GROUNDING>:将句子中的短语定位到图像区域<OPEN_VOCABULARY_DETECTION>:根据指定文本查找目标<REFERRING_EXPRESSION_SEGMENTATION>:根据自然语言指代分割目标<REGION_TO_CATEGORY>:判断指定区域属于什么类别<REGION_TO_DESCRIPTION>:描述指定区域中的内容<REGION_TO_OCR>:识别指定区域中的文字<REGION_TO_SEGMENTATION>:对指定区域生成轮廓掩码
实际在算法运行中,文本还会替换成对应的英文指令模板,代码如下[6]:
self.task_prompts_without_inputs = {
    '<OCR>': 'What is the text in the image?',
    '<OCR_WITH_REGION>': 'What is the text in the image, with regions?',
    '<CAPTION>': 'What does the image describe?',
    '<DETAILED_CAPTION>': 'Describe in detail what is shown in the image.',
    '<MORE_DETAILED_CAPTION>': 'Describe with a paragraph what is shown in the image.',
    '<OD>': 'Locate the objects with category name in the image.',
    '<DENSE_REGION_CAPTION>': 'Locate the objects in the image, with their descriptions.',
    '<REGION_PROPOSAL>': 'Locate the region proposals in the image.'
}

self.task_prompts_with_input = {
    '<CAPTION_TO_PHRASE_GROUNDING>': "Locate the phrases in the caption: {input}",
    '<REFERRING_EXPRESSION_SEGMENTATION>': 'Locate {input} in the image with mask',
    '<REGION_TO_SEGMENTATION>': 'What is the polygon mask of region {input}',
    '<OPEN_VOCABULARY_DETECTION>': 'Locate {input} in the image.',
    '<REGION_TO_CATEGORY>': 'What is the region {input}?',
    '<REGION_TO_DESCRIPTION>': 'What does the region {input} describe?',
    '<REGION_TO_OCR>': 'What text is in the region {input}?',
}

self.post_processor = Florence2PostProcesser(tokenizer=tokenizer)
super().__init__(image_processor, tokenizer)

def _construct_prompts(self, text):
    # replace the task tokens with the task prompts if task token is in the text
    prompts = []
    for _text in text:
        # 1. fixed task prompts without additional inputs
        for task_token, task_prompt in self.task_prompts_without_inputs.items():
            if task_token in _text:
                assert _text == task_token, f"Task token {task_token} should be the only token in the text."
                _text = task_prompt
                break
        # 2. task prompts with additional inputs
        for task_token, task_prompt in self.task_prompts_with_input.items():
            if task_token in _text:
                _text = task_prompt.format(input=_text.replace(task_token, ''))
                break
        prompts.append(_text)
    return prompts
2.3.2. 多模态融合
有了上述的文本 prompt 后,首要的事情是利用 Tokenizer 将任务提示词转成 Token,再通过文本 Embedding 层得到向量 ,由上面得到视觉特征是 ,将它们沿着序列维度拼接:
这里不是把图像向量和文本向量逐元素相加,Florence-2 中让视觉 Token 与文本 Token 一起进入多模态 Encoder,通过 Transformer 的 Self-Attention 建立两者之间的联系。
2.4. 多模态编解码 Multimodal Encoder Decoder
2.4.1. Transformer 结构
其实这部分就是标准的 Transformer[7] 结构,如下图所示:
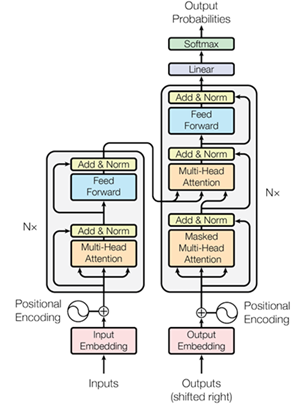
在 Transformer 网络结构中,编码器和解码器都是由多头注意力和前馈网络模块组成,在多头注意力机制中,最重要的是注意力的计算,其一般化的计算公式为:
其中, 分别是查询、键、值向量。前馈网络通常由两个线性层和非线性激活组成。
在 Transformer 网络结构中共包含了三种类型的 Attention:
- Self-Attention:在 Transformer 的编码器部分,其中 均来自于编码器部分的输入;
- Masked Self-Attention:在 Transformer 的解码器部分,其中 均来自于解码器部分的输入,与 Self-Attent 不同的是,Masked Self-Attention 并不能看到所有的文本,这个在后面的计算过程部分会详细介绍到;
- Cross-Attention:这是 Transformer 的编码器和解码器结合的部分,其中 来自于解码器的输入,而 来自于编码器的输出;
2.4.2. Encoder:把图像与提示词编码成联合表示
Encoder 接收融合后的输入序列,经过多层 Transformer Block:
其中,。这里的 不再只是原始视觉特征或原始文本特征,而是经过多层图文交互后的联合表示,是模型根据当前任务,建立了一份可以供后续生成使用的图文上下文。
2.4.3. Decoder:逐 Token 生成结果
Decoder 部分使用自回归生成文本,每一步生成一个 Token,其概率可以写成:
其中, 是之前已经生成的 Token, 是图像和提示词的融合经过 Encoder 的联合表示, 是当前要预测的 Token。
3. 把不同视觉任务都转化为序列生成
前面也提及到,Florence-2 的核心是用统一的、基于任务提示词的序列生成框架完成多种视觉任务,不再为图像分类、目标检测、目标定位、图像描述、OCR 等任务分别设计不同的模型和输出头,而是把这些视觉任务统一转换成一种基于文本序列的生成任务。
在传统的 CV 领域,通常是针对不同的任务设计不同的输出头,如:
- 图像分类,输出的是类别概率,一般设计的是分类头
- 目标检测,输出的是类别和边界框,一般设计的是分类头+回归头
- 目标分割,输出的是像素级掩码,可以设计为像素级分类头
- OCR:输出的是文字及其位置,其中文字是天然的生成问题,而位置通常又有基于目标检测的方法和基于分割的方法
- 图像描述:生成的是自然语言,这个也是天然的生成问题
在 Florence-2 算法中,其做法是把这些输出都转换成由文本 Token、特殊结构 Token 和位置 Token 组成的统一序列。
3.1. 图像描述
对于图像描述,本身输出的就是普通文本,是一个标准的生成问题,不需要其他的改造即可直接使用。
3.2. 目标检测
对于传统目标检测器,通常输出 ,其中 为边界框左上角的坐标, 为边界框右下角的坐标,如下图所示:
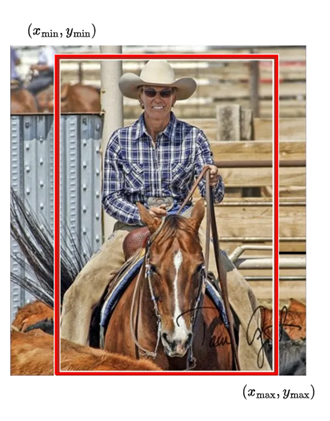
以及对应的类别 和置信度。类别本身就是离散的 Token,这里主要要处理边框的坐标,在 Pix2Seq[8] 中,采用均匀量化(Uniform Quantization),将坐标映射到有限数量的离散区间。具体的操作步骤为:
第一步,把边框坐标归一化到 。假设输入图像的宽为 ,高为 ,对上面边框坐标归一化为:
其中:
归一化之后,边框坐标都处于 到 的范围内。
第二步,将归一化后的边框坐标量化为离散的整数,采用的公式为:
其中, 是离散的 bins 的数量, 表示的是上述的归一化的坐标,最终输出的整数的范围为 到 。这样便得到了最终的坐标的离散化 Token。在训练的时候,每个目标被编码成个离散的 Token,如下所示:
其中, 是类别的 token。如果一个图片中存在多个目标,就把各个目标的 个 Token 依次串接起来,最后添加一个 EOS Token,表示结束。
在 Florence-2 中也基本一致,不同的是上述的 为 ,取值为 ,这样,一个任意实数坐标就映射为了一个 的整数,对应一个 <loc_n> Token。
Florence-2 的位置 Token 体系将连续坐标量化到有限的离散位置词表中。因此,模型预测的是有限词表中的 Token,而不是直接在一个无限可能的实数空间里选择任意坐标。生成结束后,再将这些 Token 解码成实际的数值坐标。
3.3. OCR
OCR 可以分成两类,一类是普通 OCR,也就是识别图片中的文字,输出字符串,这是标准的生成问题,不需要其他的改造即可直接使用。
另一类是带区域的 OCR,不仅要识别文字,还输出文字对应的位置,对于有旋转或倾斜的文字,区域可以使用四边形坐标表达,而不一定只是水平矩形。与上面的目标检测一致,不同的是目标检测中是两个点,在带区域的 OCR 中需要四个点,也就是 个位置的 Token,这里就不再赘述。
3.4. 视觉定位(Grounding)
视觉定位问题中,模型需要找出句子中短语所指向的图像区域,并生成相应位置。一般视觉定位的输出范式为:<ref>{phrase_text}</ref><box><loc_x1><loc_y1><loc_x2><loc_y2></box>。其中,<ref>...</ref> 部分包裹被定位的短语文本。这对标签是 Grounding 任务区别于纯检测的关键标志,明确指示了“这个框是对应这个短语的”。<box>...</box> 部分包裹该短语对应的边界框,这个与目标检测一致。
3.5. 分割
分割任务一般输出的是多边形,与检测和 OCR 固定 4 或 8 个坐标不同,分割需要输出可变数量的点来勾勒不规则形状,这通过一套分层标记(<poly>、<sep>、</poly>)来组织可变长度的点序列。分割的原始输出序列在 Grounding 的“短语-区域”配对基础上,用一对 <poly> 标签包裹一个多边形实例,并用 <sep> 分隔各个顶点。其范式可概括为:{phrase_text}<poly><loc_x₁><loc_y₁><sep><loc_x₂><loc_y₂><sep>... </poly>。其中,<poly>...</poly> 用于界定一个完整的多边形实例。一个输出序列中可能包含多对,对应多个分割对象。<sep> 分隔多边形中的各个顶点。每个顶点由一对 <loc_x><loc_y> 表示。<loc_...> 与之前完全一致,是量化到 [0, 999] 的坐标Token。点的数量不固定,由物体形状复杂度决定。
3.6. 区域理解
区域理解要求模型描述给定区域中的内容,其输入是一个坐标化的边界框。在模型的提示构造逻辑中,这个边界框会以 <loc_x1><loc_y1><loc_x2><loc_y2> 的量化 Token 形式嵌入到任务提示中。最终的输出就是纯文本了。
4. Florence-2 模型的训练
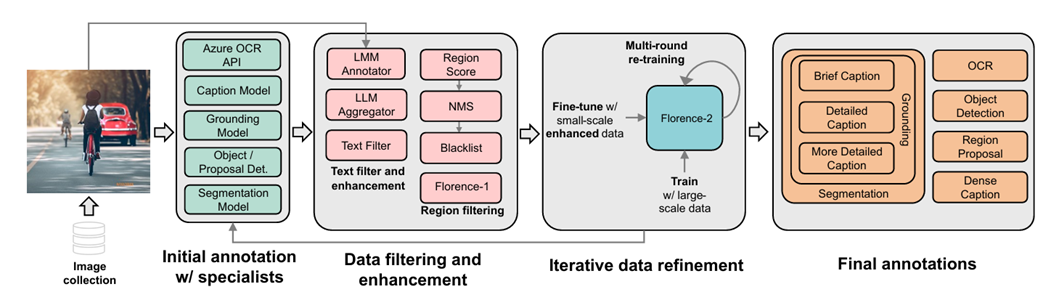
要学习通用的视觉模型,需要的数据也是非常多的,至少要能覆盖上面所有的类型,在参考文献[1]中还有一项非常重要的工作就是构建了 FLD-5B 数据集。参考文献[1]中提及到 FLD-5B 包含约 1.26 亿张图像、54 亿条视觉标注。这些标注覆盖多种视觉任务,包括图像描述、物体定位、区域描述和分割等。
参考文献中还采用了迭代式的数据构建与自动标注策略。其核心思想是利用现有数据和自动标注能力扩展标注覆盖面,再通过迭代改进数据与模型,而不是完全依赖人工逐张标注所有任务,其过程如下图所示:
5. 总结
Florence-2 主要解决的问题是如何把多种视觉任务统一为一个生成模型,为了达成这样的目标,在 Florence-2 算法中涉及到三个主要的部分:1. DaViT 视觉编码器,用于提取图片的语义信息;2. 多模态融合,用于提示词和图像语义的拼接;3. 多模态编解码器,根据指定的任务 prompt,生成最终的任务结果。这一套方案将众多领域的视觉问题都转化成了生成问题,对于数据的共享,输出的一致性提升较大;但是不同的问题的统一抽象也不等于每个任务都达到专用模型的最优性能,不过,算是在统一视觉模型领域前进很大一步。
参考文献
[1] Xiao B, Wu H, Xu W, et al. Florence-2: Advancing a unified representation for a variety of vision tasks[C]//2024 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). IEEE, 2024: 4818-4829.
[2] Yuan L, Chen D, Chen Y L, et al. Florence: A new foundation model for computer vision[J]. arXiv preprint arXiv:2111.11432, 2021.
[3] Ding M, Xiao B, Codella N, et al. Davit: Dual attention vision transformers[C]//European conference on computer vision. Cham: Springer Nature Switzerland, 2022: 74-92.
[4] Dosovitskiy A, Beyer L, Kolesnikov A, et al. An image is worth 16x16 words: Transformers for image recognition at scale[J]. arXiv preprint arXiv:2010.11929, 2020.
[5] Liu Z, Lin Y, Cao Y, et al. Swin transformer: Hierarchical vision transformer using shifted windows[C]//2021 IEEE/CVF international conference on computer vision (ICCV). Ieee, 2021: 9992-10002.
[6] https://huggingface.co/microsoft/Florence-2-large/blob/main/processing_florence2.py
[7] Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need[J]. Advances in neural information processing systems, 2017, 30.
[8] Chen T, Saxena S, Li L, et al. Pix2seq: A language modeling framework for object detection[J]. arXiv preprint arXiv:2109.10852, 2021.