1. 概述
随着通用语言大模型的发展,研究者也在多模态大模型上不断探索,Qwen-VL[1] 是阿里巴巴通义千问团队在 2023 年发布的视觉语言大模型,Qwen-VL 将视觉编码器与大语言模型结合,让模型不仅能够理解图片,还能进行视觉问答、文字识别、目标定位等任务,并通过统一的语言模型接口完成这些任务,解决了如何把图像接入 LLM 的问题。
2. Qwen-VL 的原理
2.1. Qwen-VL 的整体架构
先来看下 Qwen-VL 的整体架构,如下图所示:
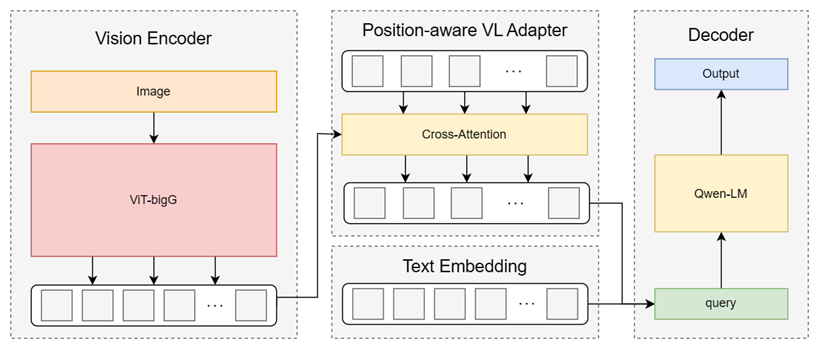
在 Qwen-VL 的整体架构中,主要的部分分为三个:
- 视觉编码器 Vision Encoder,负责将输入的图像信息转换成视觉特征序列
- 视觉语言适配器 Vision-Language Adapter,负责生成能与文本特征对齐的视觉特征
- 大语言模型 Qwen-LM,融合视觉与文本信息,进行理解、推理并按指令生成
接下来就这三个主要部分详细分析下。
2.2. 视觉编码器
在 Qwen-VL 中的视觉编码器部分采用的是 ViT-bigG,其底层是 ViT[2] 模型,我们先来回顾下 ViT 的基本原理,ViT 的结构如下所示:
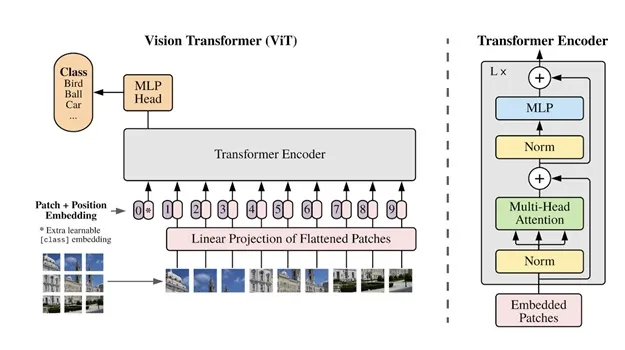
对于一张图片,首先需要将图片切成 Patch,假设输入一张 的 RGB 图片,每个 Patch 的大小为 ,则所有的 Patch 数量为:
接下来对每个 Patch 做线性映射,每个 Patch 被映射成一个固定维度的向量,如 768 维,这是时候,原始的图片被转换成 Transformer Encoder 的输入 ,即一张二维图像变成了长度为 196 的 Token 序列,每个 Token 的维度是 768。
这样就将输入的图像处理成和文本一样的序列结构,下面就可以像处理文本一样,利用标准的 Transformer Encoder 的流程处理图像,流程包括增加位置信息 Position Embedding,多头注意力 Multi-Head Self-Attention,前馈网络 MLP 等等。其中,Self-Attention 的计算方法如下:
其中,。视觉编码器的输出是一组高维特征,后续模块才负责把这些特征转化为语言模型能够理解的输入。
而在 ViT-bigG 中,输入的图片的大小为 ,每个 Patch 的大小为 ,则所有的 Patch 数量为:
经过 ViT 的计算,每个 Token 的维度为 。
2.3. 大语言模型
先来介绍大模型,目前绝大部分的 LLM 使用的是 Decoder-only Transformer[3],网络结构如下图所示:
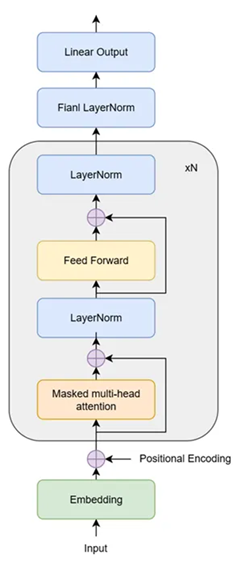
其中 xN 表示的是 N 次重复这个部分。在这个网络结构中主要有两个部分组成,分别为多头注意力(Multi Head Attention,MHA)和前馈神经网络。在多头注意力机制中,注意力的计算公式为:
其中 分别是查询、键、值向量。在 Decoder-only Transformer 结构中,需要在 Attention 的计算过程中加入掩码矩阵,以防止前面的 Token 与后面的 Token 做注意力的计算,因此上述的计算公式在 Decoder-only Transformer 结构中应该为:
其中,矩阵 M 称为掩码矩阵,格式为:
掩码矩阵是一个下三角矩阵,这样经过 softmax 计算后,对角线以上的部分都为 0,保证了前面的 Token 不会看见后面的 Token。Decoder-only Transformer 是一个自回归语言模型,从自回归语言模型的角度看,后面的文本的生成依赖于所有前面的文本:
其中: 为图像经过视觉编码器和连接器得到的视觉表示; 为用户的问题或指令; 为已经生成的前文。那么图像特征 和文本的特征 在 Qwen-VL 中是以什么样的形式输入到大语言模型中的呢?这就需要使用到视觉语言适配器 Vision-Language Adapter。
2.4. 视觉语言适配器
视觉语言适配器 Vision-Language Adapter 的作用是对视觉编码器的输出向量压缩,首先我们来看一下完整的对话应该是什么样子的。假设有如下的对话,其中,System Prompt 为“You are a helpful assistant.”,用户给出一张 的图片并提问“请描述这张图片”,助手需要回答。经过 chat template 和 Processor 展开后,送入 LLM 的文本序列大致如下:
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
<|vision_start|><|image_pad|><|image_pad|>...<|image_pad|><|vision_end|>请描述这张图片<|im_end|>
<|im_start|>assistant
这里 <|vision_start|> 和 <|vision_end|> Token 之间的 <|image_pad|> 就是给图像预留的 Token 位置,且在 Qwen-VL 中这是一个固定的值,为 ,但是视觉编码器产出的有 个 Token 的向量,此时就需要对其压缩, Qwen-VL 中使用了 Position-aware Vision-Language Adapter。
其核心思想是基于交叉注意力的压缩机制,具体来说,假设视觉编码器输出 ,在连接器准备一组可学习的 Query 为 ,目标是使得 为一固定的值为 。这时就是用了交叉注意力 Cross-Attention,其中的 来自可学习的 Query,而 和 来自视觉编码器的输出,具体如下:
其中, 为位置相关的信息,用于帮助模型保留空间位置关系。
3. Qwen-VL 的训练
Qwen-VL 的训练分成了三个阶段,如下图所示:
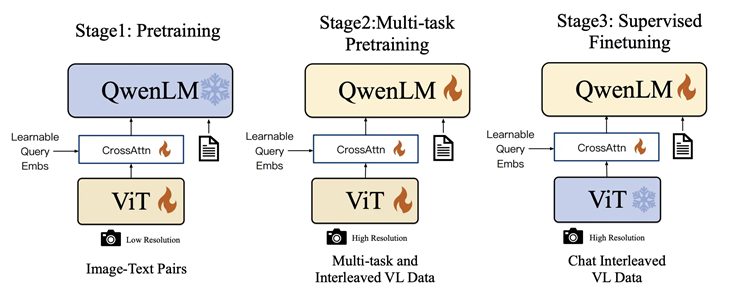
其中,阶段一是视觉语言基础预训练,此时,固定语言模型 Qwen-7B,优化视觉编码器和连接器,让视觉表示逐渐适配已有的语言模型,训练目标可以概括为条件语言建模损失:
其中, 是训练样本中正确的文本 Token。
阶段二是多任务视觉语言预训练,包括图像描述、视觉问答、定位、区域描述和 OCR 等。这个阶段就是让模型能够见到足够多的任务,教会模型把视觉特征用于特定任务。
阶段三是监督指令微调(SFT),这个阶段是让模型学会遵循人类指令并进行多轮对话,通过多模态指令、问答、定位和对话样本训练,得到交互能力更强的 Qwen-VL-Chat。
5. Qwen-VL 能处理的视觉问题
Qwen-VL 将视觉编码器与大语言模型结合,让模型不仅能够理解图片,还能进行视觉问答、文字识别、目标定位等任务,并通过统一的语言模型接口完成这些任务,但是并不是 Qwen-VL 能够解决所有的视觉问题,根据 Qwen-VL 的 GitHub README[4],除了生成文本类问题,如图像描述,通用视觉问答,OCR 与文字理解以及图表与文档理解之外,有一类问题必须要单独拿出来讲的,那就是目标定位(Visual Grounding)问题,简单来说就是模型需要找出句子中短语所指向的图像区域,并生成相应位置,在 Qwen-VL 中依旧是把坐标编码成语言模型可以生成的文本序列。
熟悉生成式目标检测的读者可能对 Pix2Seq[5] 或者 Florence-2[6] 熟悉,我们以目标检测为例,通常输出 ,其中 为边界框左上角的坐标, 为边界框右下角的坐标,如下图所示:
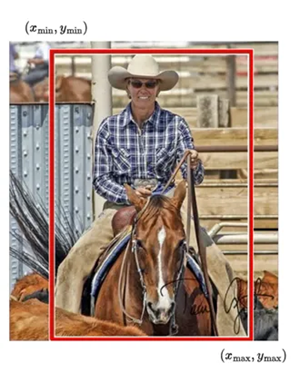
以及对应的类别 和置信度。类别本身就是离散的 Token,这里主要要处理边框的坐标,在 Pix2Seq 中,采用均匀量化(Uniform Quantization),将坐标映射到有限数量的离散区间。具体的操作步骤为:
第一步,把边框坐标归一化到 。假设输入图像的宽为,高为,对上面边框坐标归一化为:
其中:
归一化之后,边框坐标都处于 到 的范围内。
第二步,将归一化后的边框坐标量化为离散的整数,采用的公式为:
其中, 是离散的 bins 的数量, 表示的是上述的归一化的坐标,最终输出的整数的范围为 到 。这样便得到了最终的坐标的离散化 Token。在训练的时候,每个目标被编码成个离散的 Token,如下所示:
其中, 是类别的 token。如果一个图片中存在多个目标,就把各个目标的 个 Token 依次串接起来,最后添加一个 EOS Token,表示结束。
在 Florence-2 中也基本一致,不同的是上述的 为,取值为 ,这样,一个任意实数坐标就映射为了一个 的整数,不同的是,Florence-2 不再像 Pix2Seq 中量化为离散的正式,而是对应一个 <loc_n> Token。
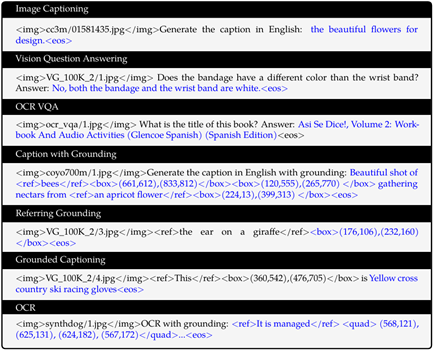
在 Qwen-VL 中,采取的方法又有点不同,首先也是与 Florence-2 中一样,对坐标归一化到 ,后直接以整数作为一个 Token,而不是像 Florence-2 中那样专门转换到一个特征的 Token <loc_n>。具体例子如下:
<ref>穿红色衣服的人</ref>
<box>(120,80),(430,920)</box>
其中,<box> 和 </box> 等特殊标记包围边界框,<ref> 和 </ref> 标记被引用的目标描述。参考文献[1]中给出了更多其他在训练时的数据格式,如下图所示:
6. 总结
放眼多模态大模型的发展过程,Qwen-VL 的提出无疑是一个重要的里程碑。纵观 Qwen-VL 的整个网络架构,包含了三个组成部分:1. 视觉编码器,用于将图像转换成视觉特征;2. 视觉语言对齐,通过连接器将视觉特征转换成 LLM 可以接收的表示;3. 大语言模型,用于根据用户指令生成对应的结果。当然这里面还有很多可以优化的地方,这也正是后续模型发力的地方。
参考文献
[1] Bai, Jinze et al. “Qwen-VL: A Versatile Vision-Language Model for Understanding, Localization, Text Reading, and Beyond.” (2023).
[2] Dosovitskiy A, Beyer L, Kolesnikov A, et al. An image is worth 16x16 words: Transformers for image recognition at scale[J]. arXiv preprint arXiv:2010.11929, 2020.
[3] Vaswani A , Shazeer N , Parmar N ,et al.Attention Is All You Need[J].arXiv, 2017.DOI:10.48550/arXiv.1706.03762.
[4] https://github.com/QwenLM/Qwen-VL/blob/master/README_CN.md
[5] Chen T, Saxena S, Li L, et al. Pix2seq: A language modeling framework for object detection[J]. arXiv preprint arXiv:2109.10852, 2021.
[6] Xiao B, Wu H, Xu W, et al. Florence-2: Advancing a unified representation for a variety of vision tasks[C]//2024 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). IEEE, 2024: 4818-4829.