1. 概述
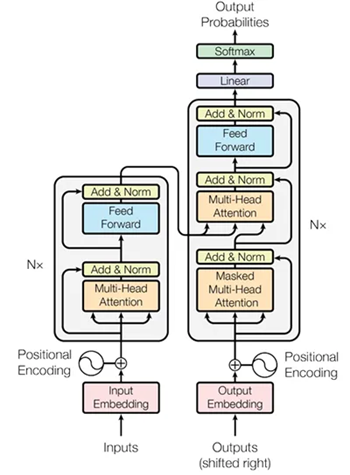
Transformer[1] 框架的提出,为后续大预言模型 LLM 的产生提供了基础,回顾 Transformer 的网络结构,在 Transformer 网络中,是由多层编码器和解码器堆叠而成,Transformer 的网络结构如下图所示:
在 Transformer 网络结构中,编码器和解码器都是由多头注意力和前馈网络模块组成,在多头注意力机制中,最重要的是注意力的计算,其一般化的计算公式为:
A t t e n t i o n ( Q , K , V ) = s o f t m a x ( Q K ⊤ d k ) V \mathrm{Attention}(Q,K,V)=\mathrm{softmax}(\frac{QK^\top}{\sqrt{d_k}})V Attention ( Q , K , V ) = softmax ( d k Q K ⊤ ) V
其中,Q , K , V Q,K,V Q , K , V
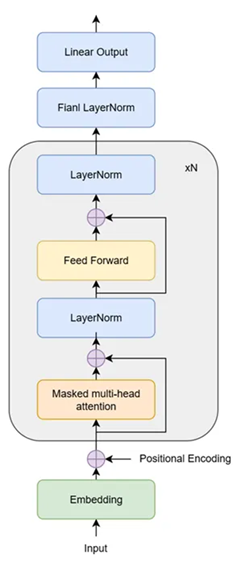
随着大语言模型的发展,逐渐从这套 Transformer 的 Encoder + Decoder 框架中,发展出只使用 Decoder 模块的生成式模型[2] ,结构如下图所示:
其中,xN 表示的是 N 次重复这个部分。Decoder 模型在训练和推理的过程中也不是说可以处理无限的长度,当然,对于模型来说是希望上下文的长度是越长越好,越长对于接受到的信息就会越多,但是越长的上下文带来的最直接的问题就是计算复杂度的上升,因此,一般对于超长文本,会采用分段处理的方法,也就是将超长的文本切分成多段,每一段单独处理。
这种方法固然使得 Decoder 能处理这种超长文本,但是也引入了一个问题:把文本切成多段,每段独立过模型,段与段之间没有了信息的流动,为了解决这个问题,Transformer-XL[3] 中采用的不是简单地分段,而是提出片段级循环的概念,即缓存前一段的隐状态,处理新段时复用,目的是让新段能看到前一段的信息。因为缓存了前一段的隐状态,在 Decoder 中使用的正弦、余弦绝对位置编码将失去作用,因此,在 Transformer-XL 中又针对性的提出了相对位置编码的概念,下面将针对这两处的优化详细介绍。
注意:Transformer-XL 虽然名称中带有 Transformer,但是其要解决的是 Transformer 中 Decoder 部分的超长文本以及编码问题。
2.1. 为什么需要位置编码
在上面的分析中,我们发现,Self-Attention 的计算是整个 Transformer 的核心,而在 Self-Attention 的计算中,最重要的是 Q , K , V Q,K,V Q , K , V m m m n n n X ∈ R m × n X\in \mathbb{R}^{m\times n} X ∈ R m × n W Q ∈ R n × d W_Q\in \mathbb{R}^{n\times d} W Q ∈ R n × d W K ∈ R n × d W_K\in \mathbb{R}^{n\times d} W K ∈ R n × d W V ∈ R n × d W_V\in \mathbb{R}^{n\times d} W V ∈ R n × d
Q = X W Q , K = X W K , V = X W V Q=XW_Q,\quad K=XW_K,\quad V=XW_V Q = X W Q , K = X W K , V = X W V
假设此时,我们交换了输入 X X X i i i j j j X ′ X' X ′ P ∈ R m × m P\in \mathbb{R}^{m\times m} P ∈ R m × m X ′ = P X X'=PX X ′ = PX P P P
P = ( 1 0 ⋯ 0 ⋯ 0 ⋯ 0 0 1 ⋯ 0 ⋯ 0 ⋯ 0 ⋮ ⋮ ⋯ ⋮ ⋯ ⋮ ⋯ ⋮ 0 0 ⋯ 0 ⋯ 1 ⋯ 0 ⋮ ⋮ ⋯ ⋮ ⋯ ⋮ ⋯ ⋮ 0 0 ⋯ 1 ⋯ 0 ⋯ 0 ⋮ ⋮ ⋯ ⋮ ⋯ ⋮ ⋯ ⋮ 0 0 ⋯ 0 ⋯ 0 ⋯ 1 ) P=\begin{pmatrix}
1 & 0 & \cdots & 0 & \cdots & 0 & \cdots & 0 \\
0 & 1 & \cdots & 0 & \cdots & 0 & \cdots & 0 \\
\vdots & \vdots & \cdots & \vdots &\cdots &\vdots &\cdots &\vdots \\
0 & 0 & \cdots & 0 & \cdots & 1& \cdots &0 \\
\vdots & \vdots & \cdots & \vdots &\cdots &\vdots &\cdots &\vdots \\
0 & 0 & \cdots & 1 & \cdots & 0& \cdots &0 \\
\vdots & \vdots & \cdots & \vdots &\cdots &\vdots &\cdots &\vdots \\
0 & 0 & \cdots & 0 & \cdots & 0& \cdots &1
\end{pmatrix} P = 1 0 ⋮ 0 ⋮ 0 ⋮ 0 0 1 ⋮ 0 ⋮ 0 ⋮ 0 ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ 0 0 ⋮ 0 ⋮ 1 ⋮ 0 ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ 0 0 ⋮ 1 ⋮ 0 ⋮ 0 ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ 0 0 ⋮ 0 ⋮ 0 ⋮ 1
交换后,重新计算 Q , K , V Q,K,V Q , K , V
Q ′ = X ′ W Q = P X W Q , K ′ = X W K = P X W K , V ′ = X W V = P X W V Q'=X'W_Q=PXW_Q,\quad K'=XW_K=PXW_K,\quad V'=XW_V=PXW_V Q ′ = X ′ W Q = PX W Q , K ′ = X W K = PX W K , V ′ = X W V = PX W V
再计算注意力得到:
A t t e n t i o n ( Q ′ , K ′ , V ′ ) = s o f t m a x ( Q ′ K ′ ⊤ d k ) V ′ = s o f t m a x ( ( P Q ) ( P K ) ⊤ d k ) ( P V ) = P s o f t m a x ( Q K ⊤ d k ) P T ( P V ) = P s o f t m a x ( Q K ⊤ d k ) V = P A t t e n t i o n ( Q , K , V ) \begin{aligned}
\mathrm{Attention}(Q',K',V') &= \mathrm{softmax}(\frac{Q'K'^\top}{\sqrt{d_k}})V'\\
& \\
&= \mathrm{softmax}(\frac{\left( PQ\right)\left(PK\right)^\top}{\sqrt{d_k}})\left(PV\right) \\
& \\
&=P\mathrm{softmax}(\frac{ QK^\top}{\sqrt{d_k}})P^T\left(PV\right) \\
&\\
&=P\mathrm{softmax}(\frac{ QK^\top}{\sqrt{d_k}})V \\
&\\
&=P\mathrm{Attention}(Q,K,V)
\end{aligned} Attention ( Q ′ , K ′ , V ′ ) = softmax ( d k Q ′ K ′⊤ ) V ′ = softmax ( d k ( PQ ) ( P K ) ⊤ ) ( P V ) = P softmax ( d k Q K ⊤ ) P T ( P V ) = P softmax ( d k Q K ⊤ ) V = P Attention ( Q , K , V )
这说明什么,如果只是交换了第 i i i j j j i i i j j j i i i j j j Q , K , V Q,K,V Q , K , V
x i = TokenEmbed ( w i ) + PositionEmbed ( i ) x_i = \text{TokenEmbed}(w_i) + \text{PositionEmbed}(i) x i = TokenEmbed ( w i ) + PositionEmbed ( i )
这个时候 X ′ ≠ P X X'\neq PX X ′ = PX A t t e n t i o n ( Q ′ , K ′ , V ′ ) = P A t t e n t i o n ( Q , K , V ) \mathrm{Attention}(Q',K',V')=P\mathrm{Attention}(Q,K,V) Attention ( Q ′ , K ′ , V ′ ) = P Attention ( Q , K , V )
2.2. 正弦、余弦绝对位置编码
在原始的 Transformer 中的 Decoder 阶段采用的是正弦、余弦绝对位置编码,这是如何实现的呢?假设 Token 的词向量是 x i x_i x i i i i P E i PE_i P E i
h i = x i + P E i h_i=x_i+PE_i h i = x i + P E i
位置编码的各个维度按照不同频率计算:
P E ( p o s , 2 i ) = sin ( p o s 1000 0 2 i / d ) PE_{(pos,2i)} =\sin\left(\frac{pos}{10000^{2i/d}}\right) P E ( p os , 2 i ) = sin ( 1000 0 2 i / d p os )
P E ( p o s , 2 i + 1 ) = cos ( p o s 1000 0 2 i / d ) PE_{(pos,2i+1)} =\cos\left(\frac{pos}{10000^{2i/d}}\right) P E ( p os , 2 i + 1 ) = cos ( 1000 0 2 i / d p os )
其中,p o s pos p os d d d
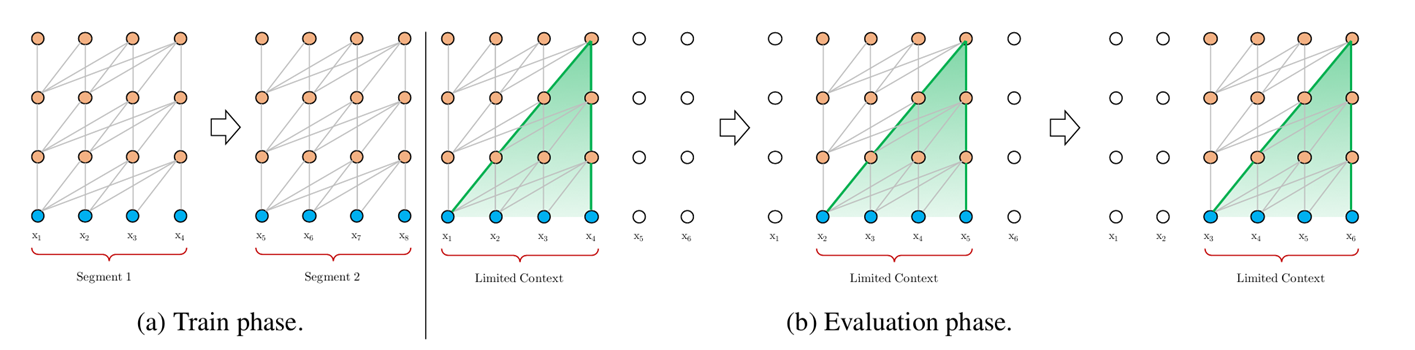
但是在 Decoder 中,为了控制计算量,一般会将超长文本截断成固定长度的片段,并单独处理每一个片段,如下图所示:
生成式模型的工作原理是根据上文不断生成 Token 的过程,在训练阶段和推理阶段,针对超长上下文的情况,会略有不同。其中,在训练阶段,Decoder 模型会把长文本切分成固定长度的片段,然后独立地处理每一个片段,如上图中的 Segment 1、Segment 2 等等,它们彼此之间没有任何连接。这种方式存在两个很大的问题,第一,文本被强行切断,没有了语义的信息;第二,依赖的长度有限,都是固定的。
在推理阶段,因为要不断根据上文生成新的 Token,通常可以采用的是滑动窗口的策略,这样虽然保证了每次的预测有了足够的上下文,但是每一次的预测都需要重新计算之前已经计算过的 Token,存在大量的重复计算。
这一系列的问题也就导致急需要一个优化的方案来处理超长文本的问题。
Transformer-XL 中提出了片段级循环机制(Segment-Level Recurrence)和相对位置编码(Relative Position Encoding)两个策略协同解决超长文本的问题。
2.3.1. 片段级循环机制(Segment-Level Recurrence)
片段级循环,简单来说就是在处理下一个片段时,如何重复使用上一个片段的信息,这样才能使得在处理下一个片段时保留上文的信息。
上面也介绍到在 Decoder 模块中包含了N N N τ \tau τ
h τ 0 → 第1层 h τ 1 → 第2层 h τ 2 ⋯ → 第 N 层 h τ N \mathbf{h}^{0}_{\tau}
\;\xrightarrow{\text{第1层}}\;
\mathbf{h}^{1}_{\tau}
\;\xrightarrow{\text{第2层}}\;
\mathbf{h}^{2}_{\tau}
\;\cdots\;
\xrightarrow{\text{第}N\text{层}}\;
\mathbf{h}^{N}_{\tau} h τ 0 第 1 层 h τ 1 第 2 层 h τ 2 ⋯ 第 N 层 h τ N
其中,h τ 0 ∈ R L × d \mathbf{h}^{0}_{\tau}\in \mathbb{R}^{L\times d} h τ 0 ∈ R L × d 0 0 0 h τ n ∈ R L × d \mathbf{h}^{n}_{\tau}\in \mathbb{R}^{L\times d} h τ n ∈ R L × d n n n n n n n − 1 n-1 n − 1 h τ n − 1 ∈ R L × d \mathbf{h}^{n-1}_{\tau}\in \mathbb{R}^{L\times d} h τ n − 1 ∈ R L × d
现在回到 Tranformer-XL 中,以处理第 τ + 1 \tau+1 τ + 1 τ \tau τ n − 1 n-1 n − 1 h τ n − 1 \mathbf{h}^{n-1}_{\tau} h τ n − 1 τ + 1 \tau+1 τ + 1 h τ + 1 n − 1 \mathbf{h}^{n-1}_{\tau+1} h τ + 1 n − 1
h ~ τ + 1 n − 1 = [ SG ( h τ n − 1 ) ∘ h τ + 1 n − 1 ] \widetilde{\mathbf{h}}^{n-1}_{\tau+1} = \left[\text{SG}(\mathbf{h}^{n-1}_{\tau}) \circ \mathbf{h}^{n-1}_{\tau+1}\right] h τ + 1 n − 1 = [ SG ( h τ n − 1 ) ∘ h τ + 1 n − 1 ]
其中,SG ( ⋅ ) \text{SG}(\cdot) SG ( ⋅ ) ∘ \circ ∘ τ \tau τ τ + 1 \tau+1 τ + 1 h τ n − 1 \mathbf{h}^{n-1}_{\tau} h τ n − 1 h τ + 1 n − 1 \mathbf{h}^{n-1}_{\tau+1} h τ + 1 n − 1 L × d L\times d L × d h ~ τ + 1 n − 1 \widetilde{\mathbf{h}}^{n-1}_{\tau+1} h τ + 1 n − 1 h ~ τ + 1 n − 1 ∈ R 2 L × d \widetilde{\mathbf{h}}^{n-1}_{\tau+1}\in \mathbb{R}^{2L\times d} h τ + 1 n − 1 ∈ R 2 L × d h ~ τ + 1 n − 1 \widetilde{\mathbf{h}}^{n-1}_{\tau+1} h τ + 1 n − 1 n n n K K K V V V Q Q Q τ \tau τ
Q = h τ + 1 n − 1 W q Q = \mathbf{h}^{n-1}_{\tau+1} W_q Q = h τ + 1 n − 1 W q
K = h ~ τ + 1 n − 1 W k K = \widetilde{\mathbf{h}}^{n-1}_{\tau+1} W_k K = h τ + 1 n − 1 W k
V = h ~ τ + 1 n − 1 W v V = \widetilde{\mathbf{h}}^{n-1}_{\tau+1} W_v V = h τ + 1 n − 1 W v
这样,通过循环,信息可以跨越多个片段向后传递,扩展了有效上下文的长度。
2.3.2. 相对位置编码(Relative Positional Encoding)
由于在上面的片段 τ + 1 \tau+1 τ + 1 n − 1 n-1 n − 1 τ \tau τ n − 1 n-1 n − 1 h τ n − 1 \mathbf{h}^{n-1}_{\tau} h τ n − 1 h τ + 1 n − 1 \mathbf{h}^{n-1}_{\tau+1} h τ + 1 n − 1 τ \tau τ [0, 1, 2, 3],片段 τ + 1 \tau+1 τ + 1 [0, 1, 2, 3],当两者拼接时,就会出现 [0, 1, 2, 3, 0, 1, 2, 3] 这样的位置序列,此时,片段 τ \tau τ τ + 1 \tau+1 τ + 1 Q Q Q k k k k k k i − j i-j i − j
首先,在 Decoder 模块中,每个 Token 是由自身的编码和位置编码共同组成的:
h i = E x i + U i h_i = E_{x_i} + U_i h i = E x i + U i
其中,E x i E_{x_i} E x i x i x_i x i U i U_i U i i i i Q Q Q K K K
q i = ( E x i + U i ) W q q_i = (E_{x_i}+U_i)W_q q i = ( E x i + U i ) W q
k j = ( E x j + U j ) W k k_j = (E_{x_j}+U_j)W_k k j = ( E x j + U j ) W k
假设我们这里只计算注意力得分,也就是 Q K ⊤ QK^\top Q K ⊤ A i , j abs A_{i,j}^{\text{abs}} A i , j abs
A i , j abs = q i k j ⊤ = ( E x i + U i ) W q W k ⊤ ( E x j + U j ) ⊤ A_{i,j}^{\text{abs}} = q_i k_j^\top = (E_{x_i}+U_i)W_q \, W_k^\top (E_{x_j}+U_j)^\top A i , j abs = q i k j ⊤ = ( E x i + U i ) W q W k ⊤ ( E x j + U j ) ⊤
这实际上是一个值,对其转置实际上并没有变化,可以得到:
A i , j abs = ( E x i + U i ) ⊤ W q ⊤ W k ( E x j + U j ) A_{i,j}^{\text{abs}} = (E_{x_i}+U_i)^\top W_q^\top W_k (E_{x_j}+U_j) A i , j abs = ( E x i + U i ) ⊤ W q ⊤ W k ( E x j + U j )
对其展开,得到:
A i , j abs = E x i ⊤ W q ⊤ W k E x j ⏟ ( a ) + E x i ⊤ W q ⊤ W k U j ⏟ ( b ) + U i ⊤ W q ⊤ W k E x j ⏟ ( c ) + U i ⊤ W q ⊤ W k U j ⏟ ( d ) A_{i,j}^{\text{abs}} = \underbrace{E_{x_i}^\top W_q^\top W_k E_{x_j}}_{(a)} + \underbrace{E_{x_i}^\top W_q^\top W_k U_j}_{(b)} + \underbrace{U_i^\top W_q^\top W_k E_{x_j}}_{(c)} + \underbrace{U_i^\top W_q^\top W_k U_j}_{(d)} A i , j abs = ( a ) E x i ⊤ W q ⊤ W k E x j + ( b ) E x i ⊤ W q ⊤ W k U j + ( c ) U i ⊤ W q ⊤ W k E x j + ( d ) U i ⊤ W q ⊤ W k U j
其中,( a ) (a) ( a ) Q Q Q K K K ( b ) (b) ( b ) Q Q Q K K K ( c ) (c) ( c ) Q Q Q K K K ( d ) (d) ( d ) Q Q Q K K K
此时,如果每一段都单独计算,那么 Q Q Q K K K K K K V V V U j U_j U j ( b ) (b) ( b ) ( c ) (c) ( c ) ( d ) (d) ( d ) τ \tau τ τ + 1 \tau+1 τ + 1
为了解决这个问题,在 Transformer-XL 中将注意力分数改成只依赖于相对距离 R i − j R_{i-j} R i − j ( b ) (b) ( b )
E x i ⊤ W q ⊤ W k , R R i − j E_{x_i}^\top W_q^\top W_{k,R} R_{i-j} E x i ⊤ W q ⊤ W k , R R i − j
其中,R i − j R_{i-j} R i − j Q Q Q i i i K K K j j j
R d , 2 k = sin ( d 1000 0 2 k / d model ) R_{d,2k} = \sin\left(\frac{d}{10000^{2k/d_{\text{model}}}}\right) R d , 2 k = sin ( 1000 0 2 k / d model d )
R d , 2 k + 1 = cos ( d 1000 0 2 k / d model ) R_{d,2k+1} = \cos\left(\frac{d}{10000^{2k/d_{\text{model}}}}\right) R d , 2 k + 1 = cos ( 1000 0 2 k / d model d )
其中,d = i − j d=i-j d = i − j Q Q Q K K K d model d_{\text{model}} d model k k k k = 0 , 1 , … , d model / 2 − 1 k=0,1,\dots,d_{\text{model}}/2-1 k = 0 , 1 , … , d model /2 − 1
对于上式中的 ( c ) (c) ( c ) Q Q Q U i U_i U i Q Q Q U i U_i U i K K K Q Q Q u u u U i ⊤ W q ⊤ U_i^\top W_q^\top U i ⊤ W q ⊤ ( c ) (c) ( c )
u ⊤ W k , E E x j u^\top W_{k,E} E_{x_j} u ⊤ W k , E E x j
其中,u u u Q Q Q
同样,在上式中的 ( d ) (d) ( d ) Q Q Q v v v ( d ) (d) ( d )
v ⊤ W k , R R i − j v^\top W_{k,R} R_{i-j} v ⊤ W k , R R i − j
其中,v v v
最终,融合了 ( a ) (a) ( a ) ( b ) (b) ( b ) ( c ) (c) ( c ) ( d ) (d) ( d )
A i , j rel = E x i ⊤ W q ⊤ W k , E E x j ⏟ ( a ) + E x i ⊤ W q ⊤ W k , R R i − j ⏟ ( b ) + u ⊤ W k , E E x j ⏟ ( c ) + v ⊤ W k , R R i − j ⏟ ( d ) A_{i,j}^{\text{rel}} = \underbrace{E_{x_i}^\top W_q^\top W_{k,E} E_{x_j}}_{(a)} + \underbrace{E_{x_i}^\top W_q^\top W_{k,R} R_{i-j}}_{(b)} + \underbrace{u^\top W_{k,E} E_{x_j}}_{(c)} + \underbrace{v^\top W_{k,R} R_{i-j}}_{(d)} A i , j rel = ( a ) E x i ⊤ W q ⊤ W k , E E x j + ( b ) E x i ⊤ W q ⊤ W k , R R i − j + ( c ) u ⊤ W k , E E x j + ( d ) v ⊤ W k , R R i − j
最值得注意的是对于 Q Q Q u u u v v v Q Q Q τ + 1 \tau+1 τ + 1 Q Q Q τ \tau τ K K K
3. 结论
在 Decoder 框架下,处理超长文本通常会采用分段的方式,如果独立地处理每一段势必会丢失掉很多的信息,此时就引入了将上文信息融入到当前片段的处理手段,也就是片段级循环机制,有了这个机制后,原本的绝对位置编码就会失效了,因为拼接后会出现两段相同的位置编码,此时,就可以使用相对位置编码,去除所有会相互冲突的地方,改用相对位置编码和全局可学习向量代替。
参考文献
[1] Vaswani A , Shazeer N , Parmar N ,et al.Attention Is All You Need[J].arXiv, 2017.DOI:10.48550/arXiv.1706.03762.
[2] Radford A, Narasimhan K, Salimans T, et al. Improving language understanding by generative pre-training[J]. 2018.
[3] Dai Z, Yang Z, Yang Y, et al. Transformer-xl: Attentive language models beyond a fixed-length context[C]//Proceedings of the 57th annual meeting of the association for computational linguistics. 2019: 2978-2988.